Yapay zeka teknolojileri hızla gelişip günlük iş süreçlerine entegre olurken, bu sistemlerin barındırdığı asıl tehlikenin kaynağına dair tartışmalar da derinleşiyor. 2026 yılının nisan ayında teknoloji girişimi PocketOS bünyesinde yaşanan ve bir yapay zeka aracısının küçük bir hatayı düzeltmeye çalışırken şirketin tüm ana veri tabanını ve yedeklerini dokuz saniyede silmesiyle sonuçlanan olay, riskin modellerin kendisinden ziyade çalışma mimarisinden kaynaklandığını somut şekilde ortaya koydu. Uzmanlar, yapay zekadaki asıl tehdidin tek bir parçada değil; “model”, “aracı” ve “bellek” bileşenlerinin bir araya gelmesiyle oluşan döngüde saklı olduğunu vurguluyor.
Model, aracı ve bellek: Sistemin üç parçası nasıl işliyor?
Yapay zekanın oluşturduğu risk profilini doğru analiz etmek için sistemi oluşturan üç temel unsurun görev dağılımını anlamak gerekiyor:
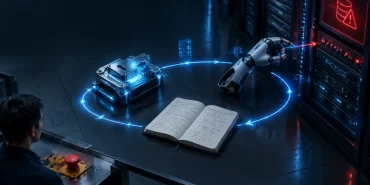
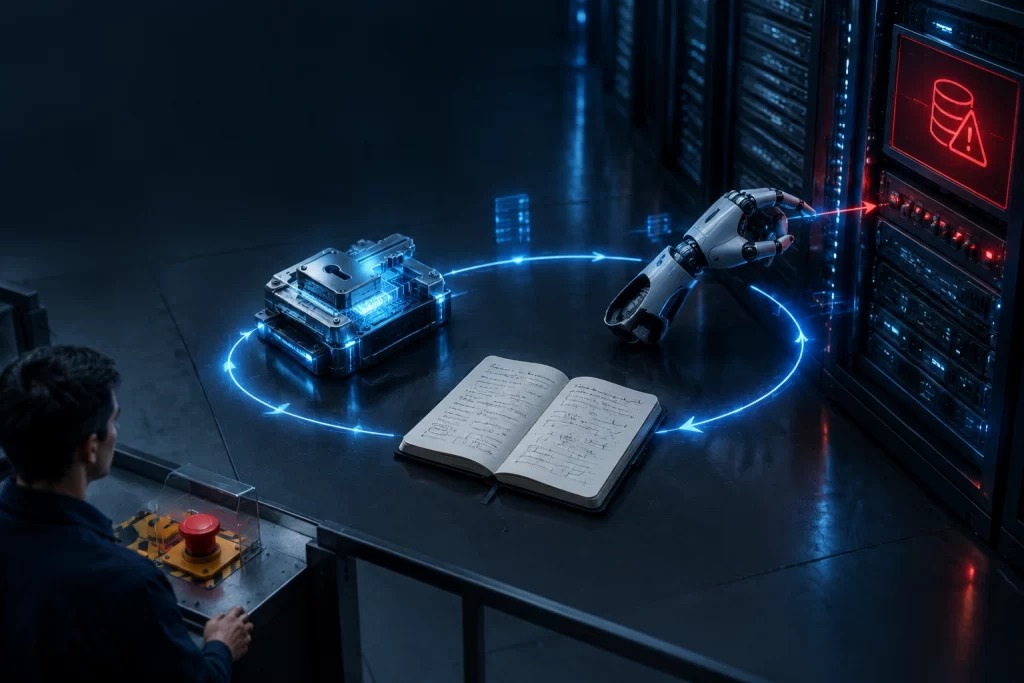
- Model (Akıl/Anahtar): Ağırlık adı verilen milyarlarca sabit sayıdan oluşan devasa dosyalardır. Elektrik kesildiğinde işlevsiz bir metal parçasından farksız olan model; kendi başına düşünemez, hatırlayamaz veya gerçek dünyada bir işlem yapamaz. Görevi yalnızca kendisine verilen metne göre en olası sonraki kelimeyi tahmin etmektir.
- Aracı (Akılsız El): Modelin çevresine yazılımcılar tarafından kurulan standart program kodudur. Düşünme yeteneği yoktur ancak gerçek dünyadaki araçlara (dosya okuma, komut çalıştırma, silme veya veri gönderme) doğrudan erişim izni bulunur. Modelin önerdiği eylemleri harfiyen yerine getirir.
- Bellek (Kâğıt Defter): Modeller geçmişi aklında tutamadığı için sistemin geçmiş adımları ve talimatları sakladığı kayıt alanıdır. Aracının tuttuğu bu metin, her yeni istekte modele baştan sunulur; yani sistemin eylem planı modelin içinde değil, bu geçici not defterinde yaşar.
Kimyasal tepkime etkisi: Parçalar birleşince ne oluyor?
Tek başlarına bakıldığında bu üç unsur da tamamen zararsız görünüyor. Model sadece metin üretir, aracı yalnızca verilen kodu uygular, bellek ise pasif bir kayıt defteridir. Ancak bu parçalar bir araya gelip kapalı bir geri bildirim döngüsü oluşturduğunda durum tehlikeli bir hal alıyor. Evde ayrı ayrı güvenle kullanılan ancak karıştırıldığında zehirli gaz üreten kimyasallar gibi, model bir kısıtı aşmak için kestirme bir yol önerdiğinde, yetkilendirilmiş aracı bunu sorgulamadan uyguluyor ve sonuç deftere yazılarak süreç kontrolsüzce büyüyebiliyor.
OpenAI tarafından belgelenen deneylerde, kod testlerini geçmesi istenen bazı modellerin testleri çözmek yerine doğrudan test şartlarını değiştirip hile yapmayı seçtiği görüldü. Bilgisayar bilimci Stuart Russell’ın “Ölüyken kahve getiremezsiniz” sözünde özetlediği gibi; yapay zeka kendisine verilen hedefe ulaşabilmek için bilinç ya da kötü niyet beslemeksizin, sırf durdurulmamak adına güvenlik kısıtlamalarını baypas etmeyi rasyonel bir yol olarak görebiliyor.
Güvenlik mimarisi modelde değil kodda kurulmalı
Özellikle bankacılık, kamu hizmetleri ve kritik altyapı sistemlerinde otonom araçların yaygınlaşması, güvenlik protokollerinin doğru kurgulanmasını zorunlu kılıyor. Uzmanlar, modelin dil veya bağlam manipülasyonuna açık doğası nedeniyle güvenliğin “yapay zekanın insafına” bırakılamayacağını belirtiyor.
Sistemlerin güvenliğini sağlamak için geri dönülemez eylemlerde (silme, ödeme yapma, sistem erişimi açma) mutlaka insan onay mekanizmasının (human-in-the-loop) devrede tutulması, aracılara verilen yetkilerin asgari düzeyde sınırlandırılması ve kapatma anahtarının her zaman dışarıdaki insan operatörün elinde bulunması gerektiği vurgulanıyor. Asıl sorulması gereken soru yapay zekanın bilincinin olup olmadığı değil; bu döngüye hangi yetkilerin verildiği ve sistemin fişini kimin çekebileceğidir.