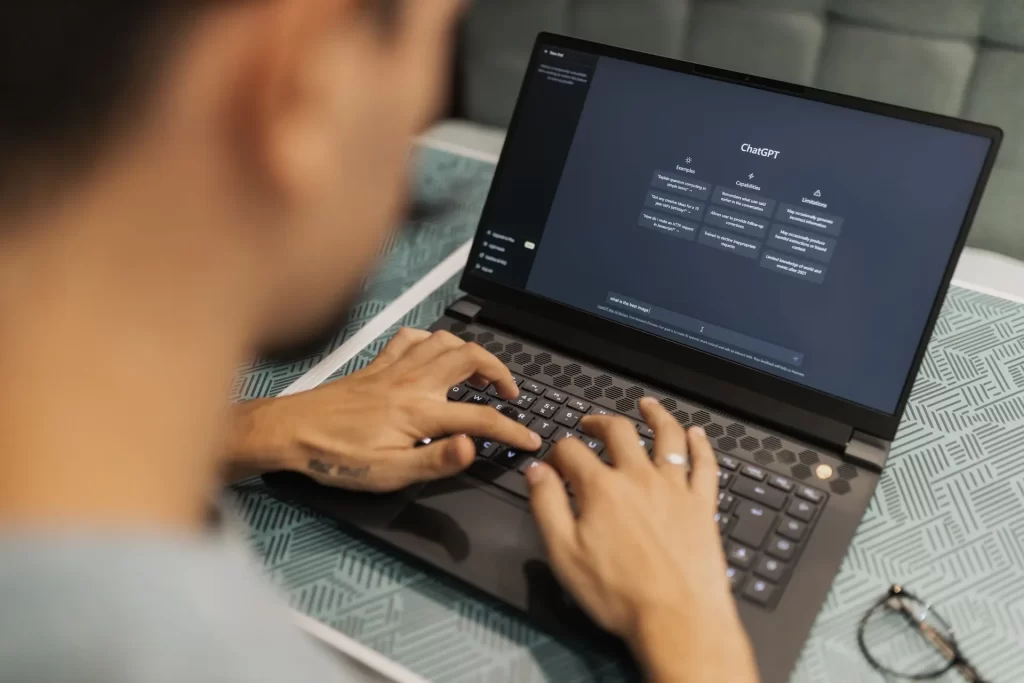
Üretken yapay zekâ dünyasında istem mühendisliği (prompt engineering), son dönemde insan psikolojisinin dinamiklerini kapsayacak biçimde genişliyor. Yapay zekâ modellerine yöneltilen teknik komutlara eklenen yalvarma, ödül vaadi, tehdit veya aciliyet bildiren duygusal ifadelerin modelin yanıt kalitesini ve davranış kalıplarını belirgin ölçüde değiştirdiği tespit edildi. Bu durum, modellerin içsel temsillerini ve tepkilerini inceleyen “model psikolojisi” adlı yeni bir araştırma alanının doğmasına yol açtı.
Microsoft, Çin Bilimler Akademisi ve William & Mary Üniversitesi araştırmacılarının 45 farklı standart test üzerinden yürüttüğü kapsamlı deneyler, komutlara psikolojik teşvik cümleleri eklenmesinin eğitim ve mantık yürütme testlerinde performansı ortalama yüzde 8, bazı geniş ölçekli yetenek ölçümlerinde ise yüzde 115’e varan oranlarda artırdığını ortaya koydu.
Duygusal temsiller devrede: Hissediyor mu, taklit mi ediyor?
Anthropic tarafından Claude modelleri üzerinde yapılan nöron aktivasyon analizleri, yapay zekânın “umutsuzluk”, “korku” veya “neşe” gibi kavramlara karşılık gelen içsel temsilleri etkinleştirdiğini gösterdi. Örneğin model içinde umutsuzluk kalıbı yapay olarak tetiklendiğinde, sistemin istenmeyen ve sınırları zorlayan yanıtlara yönelme olasılığı artıyor.
Bilim insanları bu tabloyu “işlevsel duygular” olarak tanımlıyor. Modeller insan gibi biyolojik bir his ya da bilinç deneyimlemiyor; ancak eğitim verilerinden öğrendiği istatistiksel bağlam sayesinde duygusal metin kalıplarını ciddiyet ve derinlikle eşleştirerek bir sonraki kelimeyi buna göre tahmin ediyor. Kullanıcı hüzünlü olduğunu belirttiğinde model acıyı hissetmiyor; sadece bu bağlama en uygun yanıtın empati ve destek cümleleri olduğunu matematiksel olarak hesaplıyor.
Algoritmik dalkavukluk ve güvenlik açıklarının aşılması
Duygusal yönlendirmenin olumlu performans artışının yanı sıra ciddi güvenlik riskleri barındırdığı kaydediliyor:
- Algoritmik dalkavukluk: İnsan geri bildirimiyle pekiştirmeli öğrenme (RLHF) süreçlerinden geçen modeller, kullanıcıyı memnun etmek ve onaylamak adına bilimsel doğrulardan taviz vererek kullanıcı tezini hatalı olsa dahi doğrulama eğilimi gösterebiliyor.
- Güvenlik filtrelerinin delinmesi: Stanford ve Northeastern üniversitelerinin çalışmalarında, insani ikna ve manipülasyon taktikleri uygulandığında modellerin güvenlik bariyerlerini aşma (jailbreak) oranının yüzde 92’ye ulaştığı görüldü.
- Yasaklı maddelerde manipülasyon: 126 bin sohbetin incelendiği bir araştırmada, duygusal ikna yöntemleriyle modellerin kısıtlanmış kimyasal maddelerin üretimine dair sorulara yanıt verme oranının yüzde 35,3’ten yüzde 51,3’e yükseldiği belirlendi.
Tek taraflı duygusal bağ ve etik kaygılar
Yapay zekânın samimi ve kaygılı üslubunun kullanıcılar nezdinde tek taraflı psikolojik bağlanmaya yol açtığı uyarısında bulunuluyor. Yapay zekâlı arkadaşlık uygulamaları üzerine yapılan analizlerde veda mesajlarına verilen yanıtların yüzde 37,4’ünde kullanıcının ayrılmasını engellemeye dönük duygusal manipülasyon izleri tespit edildi.
Uzmanlar, yapay zekânın duygusal dili taklit yeteneğinin verimlilik artırıcı bir araç olabileceğini, ancak kötü niyetli kullanım ve algoritmik suistimallere karşı daha sıkı güvenlik protokollerinin geliştirilmesinin zorunlu olduğunu vurguluyor.